
Eigenentwicklung · bivani GmbH
RechnerpilotVon der Berechnung
zum digitalen Produkt.
Eine kontinuierlich wachsende Plattform, in der Fachlogik, Daten, AI und Automatisierung zusammenarbeiten. Entwickelt und weiterentwickelt von bivani – als eigenes digitales Produkt.
Rechnerpilot öffnen (externe Webseite, neuer Tab)
Die Case Study erklärt die Technik. Den Rechnerpilot selbst kannst du direkt ausprobieren.
Was hinter der Oberfläche steckt
Ein Produkt.
Viele technische Ebenen.
Die sichtbare Berechnung ist der Einstieg. Dahinter stehen gemeinsame Fachmodelle, Referenzdaten und Prozesse für Inhalte, Qualität und Betrieb.
Das Backend führt Quellenzustände, Automatisierung, AI-Pipelines und Administration zusammen. Die öffentliche Oberfläche bleibt auf das konzentriert, was Nutzer verstehen und erledigen möchten.
Unser kleines, erfahrenes Team entwickelt die Fachanwendung und die Prozesse für ihren laufenden Betrieb gemeinsam.
Von der einzelnen Eingabe bis zur nachvollziehbaren Betriebsentscheidung.
- Produkterlebnis
Eine verständliche Oberfläche
React · TypeScript · Responsive · SSG / Hydration · Mehrsprachigkeit
- Gemeinsame Rechnerplattform
Definitionen verbinden Eingabe und Ergebnis
Inputs · Validierung · Fachengines · Ergebnisse · Tabellen · Diagramme · Szenarien · Exporte
- Fachliche & technische Basis
Individuelle Modelle. Kontrollierte Grundlagen.
FachlogikFinanzen, Steuern, Beruf, Sport, Technik und Alltag.
Daten & QuellenReferenzdaten, Dokumente, Monitoring, Gültigkeit und Versionen.
QualitätFachtests, Datenvalidierung, Security und Build-Gates.
- Backend & Produktprozesse
Automatisierung · AI / LLM · Publishing · SEO
Spring Boot und MongoDB verbinden Quellenzustände, geprüfte Inhalte, Jobs und nachvollziehbare Entscheidungen.
- Administration & Betrieb
Ein Produkt braucht eine Betriebsoberfläche
Eigene Analytics · Quellenradar · Knowledge Review · SEO-Cockpit · Jobs · Audits · Observability
Logische Ebenen der gemeinsamen Plattform. Verbindungen zeigen das Zusammenspiel; sie sind kein Netzwerk- oder Deploymentplan.
Gemeinsame Rechnerplattform
Standardisieren, was verbindet.
Individualisieren, was zählt.
Rechnerdefinitionen beschreiben Eingaben, Validierung und Ergebnisstruktur. Fachengines setzen das jeweilige Modell um. Spezialwerkzeuge können eigene Oberflächen und Abläufe behalten.
Werte sauber erfassen
Gemeinsame Schemata, Modi, Validierung und Sprachintegration.
Individuell berechnen
Nachvollziehbare Fachlogik mit passenden Referenzdaten.
Verständlich weiterarbeiten
Tabellen, Diagramme, Rechenwege, Guidance und Exporte.
Funktionen werden je Werkzeug passend eingesetzt. Gemeinsame Basis bedeutet keine identische Oberfläche für jede Anwendung.
Finanzen & Vermögen
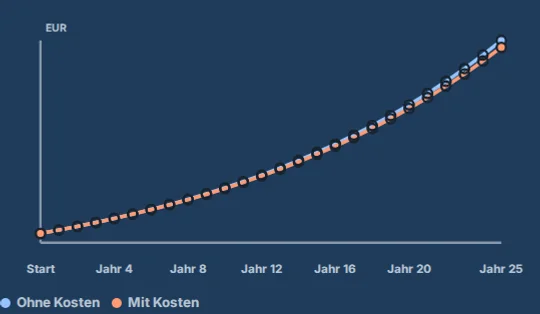
Finanzmathematik, ETF-Kosten, Steuern, Entnahme und Simulation.
Arbeit & Einkommen
Brutto-Netto, Sozialversicherung, Krankenkassen und öffentlicher Dienst.
Sport & Training
Leistungsmodelle, Trainingsgrößen und individuelle Szenarien.
Technik & Alltag
Entwicklerwerkzeuge, allgemeine Mathematik und praktische Berechnungen.
Einblick in die Fachlogik
Wenn eine einzelne
Renditeannahme nicht reicht.
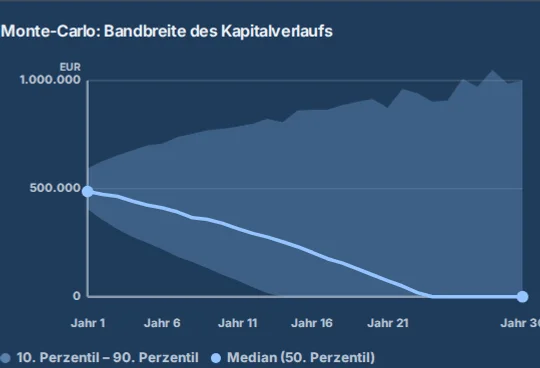
Die Monte-Carlo-Auswertung des Entnahmeplans untersucht unterschiedliche Renditepfade. Ein Seed macht die Simulation reproduzierbar; Perzentile sowie Erfolgs- und Ausfallbetrachtungen zeigen die Bandbreite des Modells.
Eine Simulation macht Annahmen prüfbar. Sie ist keine AI-Berechnung und keine Zukunftsgarantie.
AI / LLM
AI arbeitet hier
in kontrollierten Pipelines.
OpenAI ist direkt ins Backend integriert. Die Responses API erhält begrenzte Fact Packs aus vorbereiteten Quellen. Structured Outputs legen die Antwortstruktur fest; fachliche Regeln prüfen das Ergebnis.
- Belege
Geprüfte Quellen
Abruf, Extraktion und deterministische Faktenprüfung.
- Kontext
Fact Pack
Begrenzte Fakten, Quellen und erlaubte Referenzen.
- Sprache & Analyse
OpenAI
Responses API · strukturierte Ausgabe nach JSON-Schema.
- Qualitätsregeln
Validierung & Review
Deterministische Prüfung, semantische Reviews und Versionierung.
- Publishing-Gate
Veröffentlichen
Nur passende Inhalte passieren die Freigaberegeln.
AI formuliert und analysiert.
Fachengines berechnen. Regeln entscheiden.
Wissensinhalte
Textgenerierung, sprachliche Aufbereitung, Übersetzungen und semantische Reviews auf Basis belegter Fakten.
News
Überschriften, Zusammenfassungen und mehrsprachige Auswirkungsbeschreibungen. Fakten, Zahlen und Rechtsstatus bleiben kontrolliert.
SEO
Keyworderweiterung, Planung, Reviews, Ranking-/Gap-Diagnosen sowie Hinweise auf Content- und Intent-Probleme.
Die Verarbeitung ist konfigurierbar. Wissensartikel können nach bestandenen Fakten-, Sprach- und Qualitätsprüfungen automatisch veröffentlicht werden. Blockierte Versuche bleiben intern zur Prüfung; Versionen und Entscheidungen sind nachvollziehbar.
SEO als Produktprozess
Suchsignale werden
zu begründeten Aufgaben.
Search Console, Keywordverwaltung und Discovery liefern die Evidenz. AI unterstützt Planung und Diagnose. Technische Audits, Alerts und Optimierungsaufgaben führen die Ergebnisse in den Produktbetrieb zurück.
- Suchleistung
Search Console
Suchanfragen, Seiten und Leistungsdaten.
- Evidenz
Keyword Discovery
Signale zuordnen, Kandidaten bewerten und Scoring vorbereiten.
- AI-Unterstützung
Planung & Diagnose
Keyworderweiterung, semantischer Review und Ranking-/Gap-Analyse.
- Entscheidungsregeln
Deterministisch prüfen
Evidenz, Validierung und Regeln bestimmen die zulässige Aktion.
- Kontrollierte Anwendung
Admin & Autopilot
Optimierungsaufgaben und nachvollziehbare Entscheidungen.
Ein Autopilot mit klaren Schreibregeln.
Die implementierte Autopilotarchitektur unterscheidet zwischen ausgeschalteter Verarbeitung, einem Probelauf und der Anwendung zulässiger Änderungen. AI-Vorschläge passieren deterministische Prüfungen; Scores, Evidenz und Entscheidungen bleiben im Adminportal einsehbar.
SEO-Profile, Ranking- und Suchleistungsdaten, Keywordplanung und semantische Reviews gehören zusammen. Welche Pipeline aktiv ist, bestimmt die Konfiguration.

SSG / Prerendering · dynamische Serverinhalte · Canonicals · hreflang · lokalisierte URLs · Schema.org · OpenGraph · Sitemaps · Indexierungssteuerung · Redirects · interne Verlinkung
Daten & amtliche Quellen
Eine Änderung erkennen.
Ihre Bedeutung prüfen.
Rechnerpilot beobachtet externe Daten und offizielle Dokumente. HTML und PDF werden extrahiert, Daten validiert und Zustände persistiert. Ein neuer Inhalt ist zunächst ein Befund, der fachlich eingeordnet werden muss.
- Externe Quellen
Abruf & Extraktion
HTTP · HTML · RSS · JSON · PDF
- Datenqualität
Prüfen & sichern
Validierung, Hashes und versionierte Snapshots.
- Änderungen
Fachlich einordnen
Änderungserkennung, Quellenstatus und Verfahrensstatus.
- Verwendung
Kontrolliert übernehmen
Review oder Veröffentlichung nach den jeweiligen Regeln.
Ein Entwurf ist noch kein geltendes Recht.
Die Plattform unterscheidet angekündigte, entworfene, beschlossene, verkündete, in Kraft getretene und zurückgezogene Änderungen. Eine Meldung aktualisiert keinen Rechner automatisch.
Beispielhafte Verfahrensstatus, keine automatische Freigabekette.
Der passende Stand
für den passenden Zeitraum.
Versionen, Gültigkeitszeiträume, Quellenherkunft und Verifikationsstatus bestimmen die Verwendung. Prüfsummen, strukturierte Tabellen und Caches unterstützen die Datenqualität; veraltete Daten werden gesondert behandelt.
Zinsen, Wechselkurse, Inflation, Steuer- und Sozialversicherungsparameter, Krankenkassendaten sowie Entgelt- und Besoldungstabellen folgen ihrer jeweiligen Aktualisierungslogik.
Keine pauschale Livesynchronisierung aller Daten.
Quellenmonitoring ist ein dauerhafter Prozess: Checkpoints, Wiederaufnahme, begrenzte Retries, Backfills und Parserstände halten auch längere Dokumentläufe nachvollziehbar.
Administration
Das Produkt endet
nicht beim Frontend.
Ein geschütztes Adminportal macht Produkt- und Prozesszustände sichtbar. Es verbindet Nutzungsstatistik, Quellenradar, Knowledge Review und SEO-Cockpit mit den Entscheidungen dahinter.

Statistik & Zeitreihen
KPIs, Zeitraum- und Ereignisfilter sowie CSV-Export.
Quellen & Radar
Letzte Abrufe, Quellenstatus, Fehler und Dokument-/Verfahrensprüfung.
Wissen & Reviews
Versionen, Quellenbelege, Freigaben und blockierte Verarbeitungsversuche.
SEO & Jobs
Profile, Keywords, Discovery, Alerts, Jobstatus und Autopilotdetails mit Evidenz, Scores, Audits und Optimierungsaufgaben.
Originalansicht: Autopilot im Probelauf

Analytics
Zwei Datenpfade.
Bewusst getrennt.
Produktanalyse wird unabhängig von der Fachberechnung modelliert. Google Analytics und die eigene aggregierte Statistik haben unterschiedliche Aufgaben und Datenflüsse.
Google Analytics 4
GA4 wird erst nach Zustimmung geladen. Die Einwilligung ist zunächst verweigert und kann widerrufen werden.
Begrenzte Ereignisse erfassen Pageviews, Rechnernutzung, Moduswechsel, PDF, Sharing, Permalinks und ausgewählte Suchinteraktionen.
- Frontend
Begrenztes UI-Ereignis
Ereignistyp, Inhalt, Oberfläche und Sprache. Keine Recheneingaben.
- Backendvalidierung
Aggregierte Tageswerte
Geschlossenes Ereignismodell; unbekannte Felder werden abgewiesen.
- Datenhaltung
MongoDB → Statistikservice
Eigene Aggregation für Filter, Zeitreihen und Export.
- Administration
Adminportal
Aktionssummen ohne Nutzer- oder Sessionidentität.
Separater, konfigurierbarer First-Party-Datenpfad ohne eigene Cookies oder Wiedererkennung. Er ist unabhängig von der GA4-Einwilligung und importiert keine GA4-Daten.
Privacy by Design
Datenschutz beginnt
bei der Berechnung.
Öffentliche Rechnerberechnungen laufen überwiegend direkt im Browser. Viele Recheneingaben müssen für die eigentliche Berechnung deshalb gar nicht an das Backend übertragen werden.
Datensparsamkeit ist eine Architekturentscheidung. Spezialisierte Fachengines arbeiten möglichst auf dem Gerät.
Analytics erhält keine Recheneingaben oder Ergebnisse. Die eigene Statistik nutzt begrenzte Ereignisfelder ohne Nutzer- oder Sessionkennungen.
Der Adminbereich ist technisch getrennt und geschützt. Die Einwilligung in GA4 bleibt eine widerrufbare Entscheidung.
Internationalisierung
Andere Sprache.
Dasselbe Fachmodell.
Mehrsprachigkeit umfasst weit mehr als übersetzte Labels: eigene Sprachpakete, lokalisierte URLs und Metadaten, hreflang sowie passende Zahlen-, Währungs- und Datumsformate.
Sprachwechsel, chunkbasierte Sprachladung und Sprachqualitätsprüfungen gehören zur Plattform. Arabisch wird einschließlich Rechts-nach-links-Darstellung unterstützt.
Responsive Design, Tastaturbedienung, Labels, sichtbare Fokuszustände, Live-Regionen und reduzierte Bewegung ergänzen die Benutzeroberfläche. Ausgewählte Browsertests prüfen Accessibility mit axe.
Qualität, Security & Observability
Vertrauen entsteht
an den Systemgrenzen.
Fachliche Ergebnisse, externe Daten und AI-Ausgaben brauchen unterschiedliche Prüfungen. Tests, geschützte Zugänge und beobachtbare Prozesse verbinden sie zu einem betreibbaren Produkt.
Fachmodelle bleiben prüfbar.
Vitest und JUnit, fachliche Regressionen mit Steuer- und Finanzfixtures sowie Simulations- und Parsertests. MongoDB-Testcontainers sichern Integrationstests; Playwright prüft Browserabläufe, Exporte und Accessibility in ausgewählten Tests.
Schutz auf mehreren Ebenen.
Backendvalidierung, BCrypt und TOTP im geschützten Adminbereich, Session- und CSRF-Schutz. Security Headers, interne CSP, Abuse Protection, Rate Limiting, Captcha und Containerhärtung ergänzen die Architektur.
Prozesse erklären ihren Zustand.
Logging, Health Checks, Spring Boot Actuator, Docker Healthcheck und Micrometer. Jobstatus, Laufzeiten und Fehler bleiben sichtbar; Schedulerhistorie, Contentversionen und fachliche Audits machen Entscheidungen nachvollziehbar.
CI/CD & Delivery
Qualität vor dem Rollout.
Betrieb von Anfang an.
Maven bindet den Frontendbuild mit Node und Vite ein. GitLab CI/CD verbindet Build, Typechecks, Frontend- und Backendtests mit Security-Gates. Geprüfte Artefakte werden als JAR und Docker-Image weitergereicht.
- Code & Build
Maven · Node · Vite
Frontendbuild, Typechecks und Prerendering.
- Quality-Gates
Tests & Security
Frontend, Backend, Secret- und Dependency-Prüfungen.
- Artefakt
JAR → Docker
Container bauen und Security prüfen.
- Delivery
Registry → Rollout
GitLab Registry und kontrollierte Containerbereitstellung.
Gitleaks · Trivy Filesystem & Container · Semgrep · CycloneDX / SBOM
Docker · Portainer · Plesk mit HTTPS und Reverse Proxy
Browser- und Accessibility-Prüfungen ergänzen die CI-Gates. Nicht jede Browserprüfung ist als Deployment-Gate eingebunden.
Technik unter der Haube
Die Details machen
den Unterschied.
Ein genauerer Blick auf die Entscheidungen hinter Fachlogik, Browsertechnik und kontinuierlicher Verarbeitung.
Browsertechnik, die Spezialwerkzeuge möglich macht
Web Worker isolieren rechenintensive Arbeit. Das Hash-Werkzeug verarbeitet Dateien inkrementell und nutzt Web Crypto sowie Hash-WASM. Ein eigener Worker mit Watchdog begrenzt blockierende Regex-Ausführung. Der Passwortgenerator verwendet die sichere Zufallsquelle des Browsers. QR-Codes lassen sich erzeugen und zur Prüfung rückdekodieren; PDF-Dokumente werden im Browser gerendert.
Performance durch gezieltes Laden
Prerendering und Hydration bilden den Einstieg. Rechnerdefinitionen und getrennte Sprachpakete werden nach Bedarf geladen, wiederholte Ladevorgänge gemeinsam genutzt. PDF-, QR- und Hash-Funktionen bleiben außerhalb des unnötigen Einstiegscodes. Caches, Bundlebudgets und Modulprüfungen sichern diese Aufteilung ab.
Wiederaufnahme statt fragiler Einmaljobs
Persistierte Quellenzustände, Checkpoints, begrenzte Retries und Backfills machen Dokumentverarbeitung wiederaufnehmbar. Parserstände, Hashes und Snapshots helfen, Änderungen und erneute Verarbeitung auseinanderzuhalten. Gültigkeitszeiträume, Prüfsummen und Verifikationsstatus schützen die Verwendung von Referenzdaten.
Nachvollziehbare Ergebnisse und Verknüpfungen
Die gemeinsame Ergebnisstruktur unterstützt Annahmen, Quellen, Rechenwege, Tabellen, eigene SVG-Diagramme und Guidance. Szenarien, Transfers zwischen Rechnern und Permalinks halten Ergebnisse nutzbar. Druck, PDF und QR-Verknüpfungen stehen dort zur Verfügung, wo das jeweilige Werkzeug sie unterstützt. Fachliche Beziehungen verbinden Rechner und Wissensinhalte in einer gemeinsamen Verknüpfungsstruktur.
Regelbasierte Produktoptimierung
Nutzungs- und Suchdaten können in Popularität, Trendsignale, Empfehlungen und Suchreihenfolge einfließen. Diese Optimierung folgt implementierten Regeln und konfigurierbaren Datenprozessen. Sie ist kein trainiertes Machine-Learning-Modell.
Technisches SEO bis zur einzelnen Route
SSG und Prerendering ergänzen serverseitig gerenderte dynamische Inhalte. Lokalisierte URLs, Canonicals, hreflang, Schema.org, OpenGraph, Sitemaps und robots gehören zur Plattform. Indexierungssteuerung, noindex-Regeln, Redirects und interne Verlinkung werden gemeinsam mit fachlichen Inhaltsbeziehungen gepflegt.
Fachliche Regression und technische Prüftiefe
Steuer- und Finanzfixtures prüfen fachliche Modelle, Simulationstests die Reproduzierbarkeit. Weitere Tests decken Daten und Parser, Permalinks, Exporte, Sprachpakete und SEO-Verträge ab. Integrationstests nutzen MongoDB-Testcontainers; Playwright prüft Browserabläufe und in ausgewählten Tests Accessibility mit axe. Die Browserprüfungen ergänzen die in GitLab eingebundenen Build-, Frontend- und Backend-Gates.
Geschützte Verarbeitung und betriebliche Nachvollziehbarkeit
Backendvalidierung, BCrypt, TOTP als zweiter Faktor, Sessionschutz und CSRF sichern den Adminbereich. Security Headers und eine Content Security Policy für den internen Bereich ergänzen Rate Limiting, Abuse Protection und Captcha an den dafür vorgesehenen Zugängen. Secrets kommen aus Laufzeit- und Deploymentkonfiguration; der Container läuft ohne Root. Logging, Health Checks, Actuator und Micrometer machen technische Zustände sichtbar. Schedulerhistorie, Laufzeiten, Contentversionen und fachliche Audits erklären, was ein Prozess entschieden hat.
Technologie-Stack
Werkzeuge mit
einer konkreten Aufgabe.
Die technische Basis von Rechnerpilot, nach Funktion geordnet.
Produkt & Frontend
- React
- TypeScript
- Vite
- HTML / CSS
- SVG
- Web Worker
- WASM
Backend
- Java
- Spring Boot
- Spring MVC
- Spring Security
- Spring Data MongoDB
Daten
- MongoDB
- Versionierte Referenzdaten
- JSON
- HTML
- RSS
AI & Verarbeitung
- OpenAI
- Responses API
- Structured Outputs
- Fact Packs
- AI Reviews
- jsoup
- PDFBox
Analytics & SEO
- Google Analytics 4
- Google Search Console
- First-Party-Statistik
- SSG / Prerendering
- Technische SEO-Infrastruktur
Qualität
- Vitest
- JUnit
- Playwright
- Testcontainers
- axe-core
- TypeScript-Typechecks
Delivery & Betrieb
- Maven
- Node / npm
- GitLab CI/CD
- GitLab Registry
- Docker
- Portainer
- Plesk
- Actuator
- Micrometer
Browser & Security
- React-PDF
- QR / ZXing
- Hash-WASM
- Web Crypto
- Gitleaks
- Trivy
- Semgrep
- CycloneDX / SBOM
Von der Idee bis zum Produktbetrieb
Dein Projekt muss
kein Rechner sein.
Komplexe Geschäftsregeln, unterschiedliche Datenquellen, laufende Änderungen, Administration und Analytics: Diese Herausforderungen finden sich in vielen digitalen Produkten. Die Oberfläche soll trotzdem einfach bleiben.